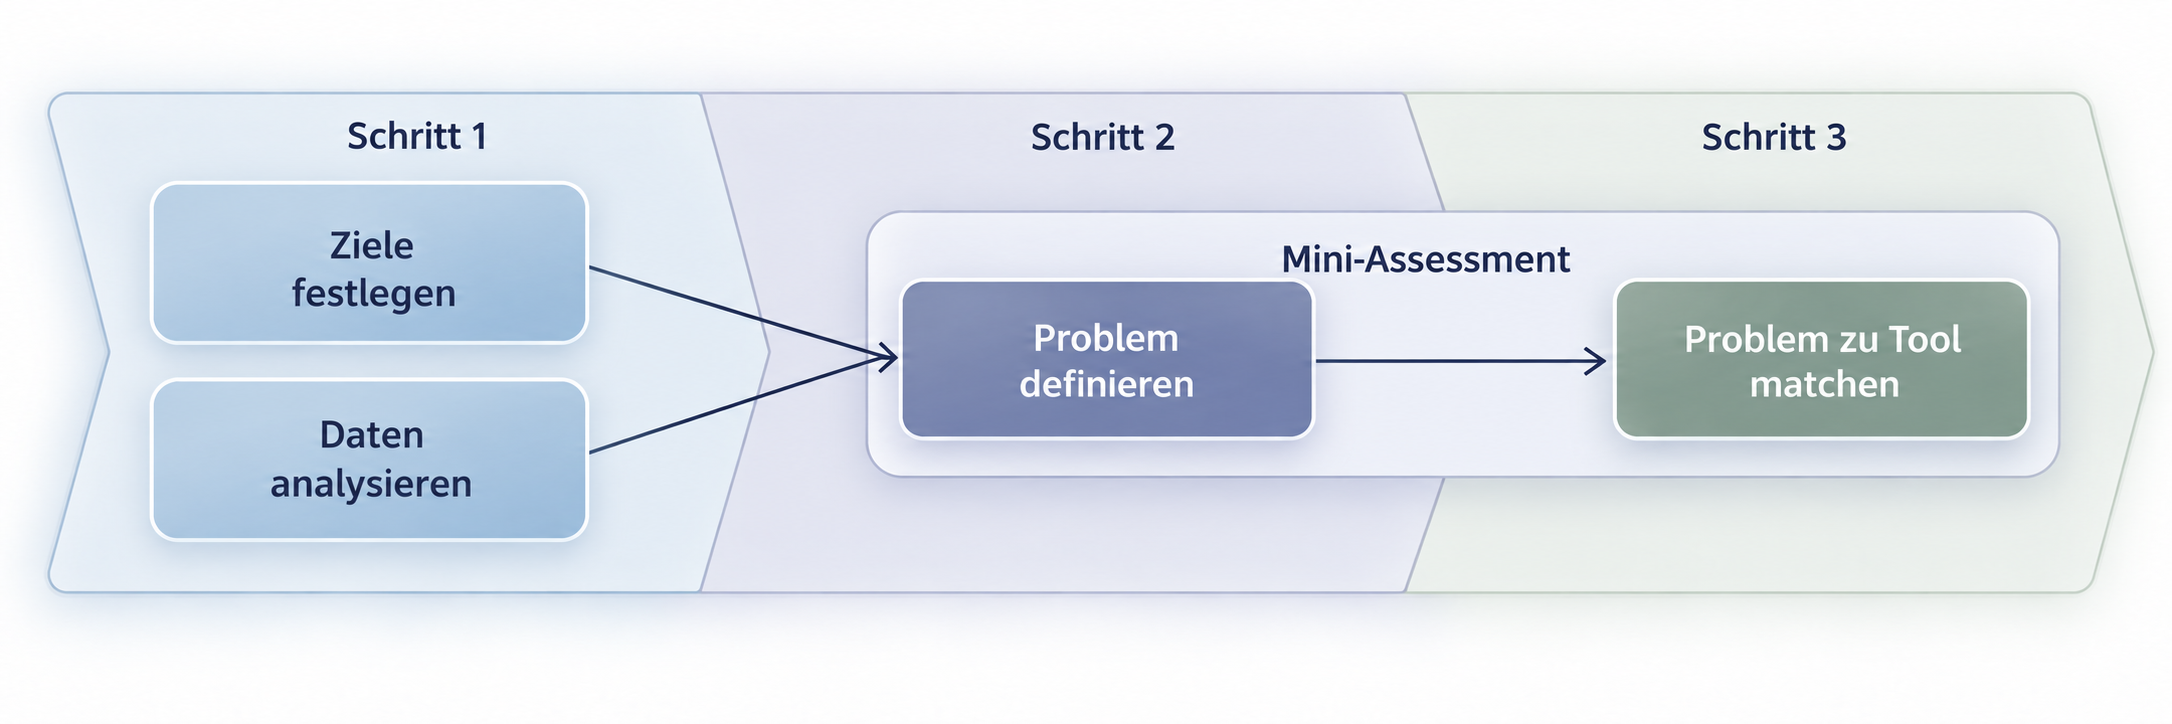
Die Wahl eines geeigneten Algorithmus für ein Machine-Learning- oder KI-Vorhaben erfordert die systematische Berücksichtigung von Zielsetzung, Datengrundlage und Rahmenbedingungen wie Interpretierbarkeit und Nachhaltigkeit. Dieser Beitrag stellt ein strukturiertes, forschungsbasiertes Vorgehen in drei Schritten für diesen Auswahlprozess vor. Ein begleitendes Mini-Assessment unterstützt Praktiker:innen dabei, die eigene Problemstellung gezielt einzuordnen.
Zentrale Features
1. Ziel(e) festlegen
Vor der Auswahl eines konkreten Machine Learning (ML) oder Künstlichen Intelligenz (KI) Algorithmus, müssen zunächst die Ziele klar definiert werden. Hierbei stehen fachliche, soziale und ethische Perspektiven im Vordergrund, wobei die Fachlichkeit für die Einschränkung des Problemtyps relevant ist und soziale und ethische Ziele für die Auswahl eines speziellen Modells.
Beim Festlegen des fachlichen Ziels steht die Frage “Wofür brauche ich den Algorithmus?” im Zentrum. Hierbei sollte man darüber nachdenken, welches Ergebnis erzeugt werden soll, ob es Besonderheiten gibt, die bei der Erzeugung berücksichtigt werden sollen, wie das Ergebnis darzustellen ist und wie damit weitergearbeitet wird. Um aus dem Ziel einen konkreten Problemtyp abzuleiten sind folgende Fragen relevant:
- Soll eine Aussage über eine noch unbekannte Information (numerischer Wert oder Kategorie) getroffen werden?
- Wenn ja, bezieht sich die Vorhersage dieser Information auf einen numerischen Wert, geht es um einen Wert in der Zukunft oder ist es eine Kategorie?
- Wenn nein, sollen Gruppen oder Muster identifiziert werden oder Anomalien bzw. Ungewöhnliches erkannt werden?
Um die sozialen Ziele zu bestimmen, stellt sich die Frage “Warum brauche ich den Algorithmus?”. Hier geht es vor allem darum, zu berücksichtigen in welchem Arbeitsprozess oder Entscheidungszyklus mit der Maßnahme eingegriffen wird und welche Mitarbeitenden von der Veränderung betroffen sind. Das betrifft vor allem die Handhabung, aber auch die Weiterverarbeitung, d.h. wie soll mit den Ergebnissen weiter umgegangen werden. Diese Überlegungen sind wichtig, um bei der Auswahl des Algorithmus eine Entscheidung über die Verständlichkeit für das Zustandekommen des Ergebnisses und die Interpretierbarkeit dessen treffen zu können.
Schließlich sind die ethischen Ziele aus ähnlichen Gründen relevant. Hier spielen Rahmenbedingungen wie ethische Richtlinien oder Unternehmenskultur eine wichtige Rolle. Eine wichtige Information, die in diesen Überlegungen mitgedacht werden muss, ist der Datenschutz. Dieser bestimmt, welche Daten, wie lange und zu welchen Verwendungszwecken gesammelt, gespeichert und weiterverwendet werden dürfen. Aber auch Regelungen zu ökologischen Nachhaltigkeitszielen sind wichtig. Große Datensätze bedürfen mehr Speicherkapazität und ML-Algorithmen für besonders große oder komplexe Datensätze mehr Ressourcen wie Wasser und Strom brauchen. Diese Punkte werden relevant, wenn es um verschiedene Abwägungen, wie Datengröße/-komplexität vs. Effizienz oder Verständlichkeit und Interpretierbarkeit, geht.
2. Datenanalyse
Neben den Zielen müssen sich im Vorfeld auch die zur Verfügung stehenden Daten angeschaut werden. Dafür werden die Eigenschaften Strukturierung, Datenlabel, Komplexität, Datenumfang und Datenqualität eingeschätzt.
Strukturierung der Daten und Label
Allgemein werden Daten in die Kategorien unstrukturiert, semi-strukturiert, strukturiert und Metadaten unterschieden. Strukturierte Daten sind wohldefiniert und liegen standardisiert, geordnet und leicht zugänglich, bspw. in Tabellen oder Datenbanken, vor. Eine spezielle Art von strukturierten Daten sind Metadaten. Metadaten sind Daten über Daten und enthalten Informationen über Autoren, Größe, Datenformate und anderen Attributen. Unstrukturierte Daten sind auf der anderen Seite nicht in ihrem Format vordefiniert oder unstrukturiert geordnet, wodurch die Erfassung, Verarbeitung und Analyse erschwert sind. Hierzu gehört Text- oder Multimediamaterial wie Emails, Wiki-Einträge, PDFs, Audio-Dateien oder Bilder. Semistrukturierte Daten sind meist nicht Datenbanken gespeichert, liegen aber in einer organisierten Struktur vor. Hierzu zählen bspw. HTML-, XML- oder JSON-Dokumente.
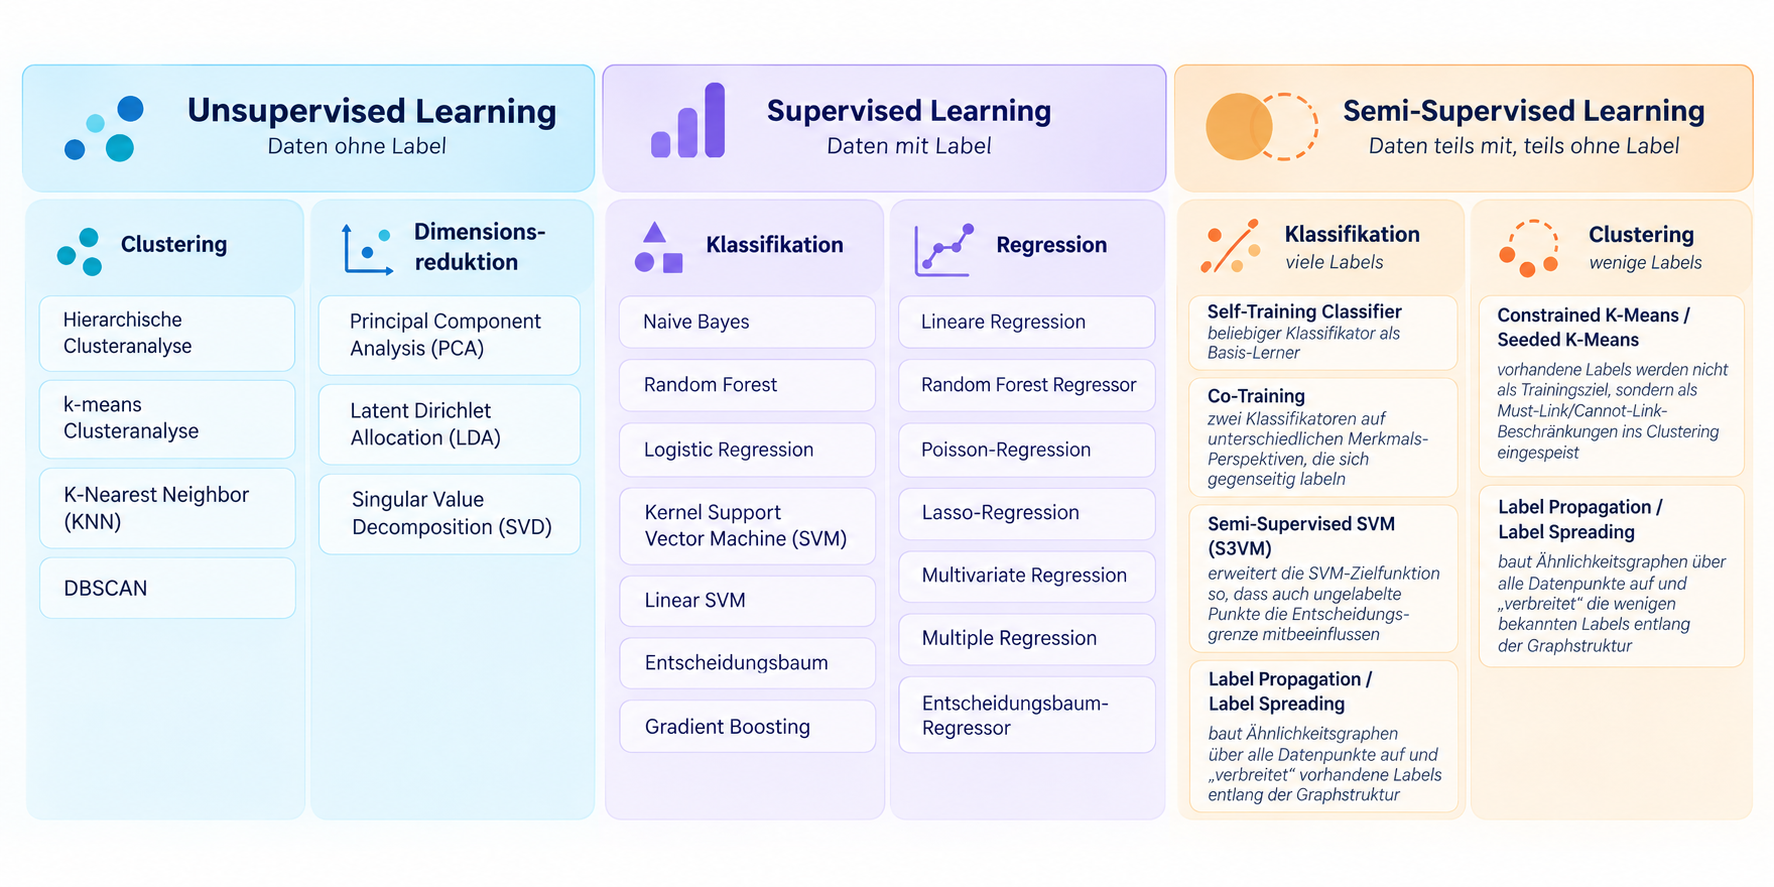
Eine weitere zentrale Eigenschaft der Daten ist, ob sie über Labels verfügen, d.h. ob für jeden Datenpunkt bereits ein bekanntes Ergebnis oder eine korrekte Zielgröße vorliegt. Man unterscheidet gelabelte Daten, bei denen jedem Datenpunkt eine „richtige" Ausgabe zugeordnet ist (z. B. eine Kategorie bei einer Bildklassifikation oder ein Zielwert bei einer Preisprognose), von ungelabelten Daten, bei denen diese Information fehlt. In der Praxis liegt häufig auch eine Mischform vor: ein kleiner gelabelter Datenbestand neben einer deutlich größeren Menge ungelabelter Daten. Ob für die Daten Label vorliegen wird je nach benötigten ML-Algorithmus bzw. dem zugrundeliegenden Lernparadigma relevant. Die beigefügte Abbildung zeigt einige Algorithmusbeispiele für die Problemtypen je nach Lernmechanismus. Gelabelte Daten sind Voraussetzung für überwachtes Lernen (Supervised Learning), bei dem ein Modell den Zusammenhang zwischen Eingabe und bekannter Ausgabe erlernt; etwa für Klassifikations- oder Regressionsaufgaben. Liegen ausschließlich ungelabelte Daten vor, kommt unüberwachtes Lernen (Unsupervised Learning) zum Einsatz, das eigenständig Strukturen oder Muster in den Daten identifiziert, beispielsweise beim Clustering. Bei einer Kombination aus wenigen gelabelten und vielen ungelabelten Daten bietet sich halbüberwachtes Lernen (Semi-Supervised Learning) an, das beide Datentypen gemeinsam nutzt.
Komplexität der Beziehungen in den Daten
Hier werden allgemein drei Stufen unterschieden: Daten mit geringer Komplexität sind z.B. Tabellen mit wenigen Attributen. Zu Daten mit mittlerer Komplexität gehören u.a. Tabellen mit vielen Attributen oder Daten, bei denen die Variablen nicht-lineare Zusammenhänge untereinander haben. Darüber hinaus können auch Bilddateien mit einer niedrigen Auflösung zu Daten mittlerer Komplexität gezählt werden. Bildmaterial mit hoher Auflösung, Texte oder Audio-Daten sind Beispiele für Daten mit hoher Komplexität.
Mit einem höheren Komplexitätsgrad nimmt auch die Größe und die Komplexität des benötigten Algorithmus für die Analyse zu. Deshalb kann es sinnvoll sein, die Komplexität der Daten zu reduzieren, da hiermit Rechenleistung und damit Ressourcen gespart werden können.
Datenumfang und Datenqualität: Dimensionalität und fehlende Werte
Datenumfang und Datenqualität überschneiden sich häufig mit Datenkomplexität. Der Umfang bezieht sich zum einen auf die Anzahl an Datenpunkte, und zum anderen auf benötigte Speicherkapazität. Zudem wird hiermit auch die Höhe der Dimensionalität der Daten beschrieben, also wie viele Attribute sie umfassen. Diese drei Punkte sind vor allem bei Effizienzfragen relevant. Abschließend ist wichtig, die Daten auf Konsistenz zu überprüfen, also zum Beispiel ob der Datensatz fehlende Werte enthält.
3. Problem definieren
Es werden im allgemeinen fünf unterschiedliche Problemtypen: Regression, Klassifikation, Time Series Forcasting, Clustering und Anomaly Detection definiert. Diese leiten sich aus dem fachlichen Ziel und den oben genannten drei Fragen ab. Regression bezeichnet den Problemtyp, wenn aus einem Datensatz ein bestimmter Datenwert vorhergesehen werden soll. Hier ist es wichtig, dass sich diese Vorhersage nicht auf einen zukünftigen Wert bezieht. Dieser gesonderte Problemfall bezeichnet Time Series Forcasting, bei dem die Fortsetzung einer Datenreihe vorhergesagt werden soll. Wenn kein numerischer Wert, sondern eine Kategorie oder Klasse vorhergesehen werden soll, liegt der Problemtyp Klassifikation vor. Je nach Anzahl an Kategorien bzw. Klassen wird hier genauer in binäre Klassifikation (2 Kategorien) und multiclass Klassifikation (mind. 3 Kategorien) unterschieden.
Neben den Problemtypen der Vorhersage gibt es die Identifikationsprobleme. Hierzu gehören zum einen die Gruppierung von Daten in Gruppen oder Cluster (Clustering). Oder es sollen Ausreißer aus den Daten herausgefiltert werden, dann handelt es sich um Anomality Detection.
Ein weiterer Punkt, der hier zu berücksichtigen ist, ist die Interpretierbarkeit. Einfachere Problemtypen bzw. einfachere Algorithmen sind einfacher zu verstehen. Es kann also Vorteil sein die Komplexität zu reduzieren, um eine bessere Interpretierbarkeit zu erhalten.
4. Problem zu Tool matchen
Im Allgemeinen lässt sich bereits aus dem fachlichen Ziel der Problemtyp und daraus ein passender Algorithmus ableiten. Jedoch zeigt sich in der Praxis, dass dies z.B. Aufgrund der Komplexität der Daten nicht immer zu geeigneten Algorithmen führt. Das Mini-Assessment kann Ihnen helfen aus den Überlegungen des ersten Schrittes eine erste Auswahl für einen passenden Algorithmus zu treffen.
Mit dem oder den ersten Kandidaten folgt nun der letzte Schritt: Experimentieren und Vergleichen. Denn die fachliche Eignung eines Algorithmus allein reicht nicht aus, um eine fundierte Entscheidung zu treffen. Genau die Abwägungen, die unter den sozialen und ethischen Zielen benannt wurden - zwischen Datengröße/-komplexität und Effizienz, zwischen Verständlichkeit und Interpretierbarkeit, sowie zur Art der Ergebnisdarstellung - werden erst in diesem Schritt konkret, wenn mehrere reale Kandidaten nebeneinanderstehen und gegeneinander abgewogen werden.
Konkret bedeutet das: Statt sich sofort auf den erstbesten empfohlenen Algorithmus festzulegen, sollten mehrere Kandidaten prototypisch umgesetzt und anhand mehrerer Dimensionen verglichen werden – nicht nur anhand der klassischen Modellgüte (z. B. Genauigkeit, F1-Score oder RMSE, je nach Problemtyp), sondern auch anhand der eingangs festgelegter Kriterien: Wie nachvollziehbar ist das Vorgehen des Modells für die Beteiligten? Wie gut lassen sich die Ergebnisse interpretieren? Und wie hoch ist der Ressourcenverbrauch im Verhältnis zum Nutzen?
Qualitative Studien zeigen, dass diese Abwägung in der Praxis häufig zu kurz kommen. In den Ergebnissen deutet sich an, dass Ressourcenüberlegungen im Entwicklungsprozess meist nachrangig behandelt werden, obwohl sie bereits bei der Modellwahl eine Rolle spielen könnten. Für diesen Guide bedeutet das: Die hier vorgeschlagene Vergleichsphase ist kein optionaler Zusatzschritt, sondern soll genau diese Lücke schließen, indem Nachhaltigkeit von Anfang an als gleichwertiges Vergleichskriterium neben der Modellgüte mitgedacht wird. Der Ressourcenaufwand bzgl. Energie, Wasserverbrauch und Hardware sollte sowohl für die Trainings- als auch für die Anwendungsphase berücksichtigt werden. In der Studie von Chaaben, Koch und Mackay aus 2025 kristallisieren sich auch Konflikte für ML-Entwickler:innen heraus, in denen Arbeitgeber oder Kund:innen häufig Profitabilität, Effizienz oder kurzfristige Ergebnisse gegenüber Nachhaltigkeits- oder Interpretierbarkeitsüberlegungen priorisieren. Dies wird durch einen allgemeinen gesellschaftlichen Trend, KI unabhängig vom tatsächlichen Bedarf einzusetzen verstärkt. Diese Dynamik kann dazu führen, dass eigentlich passendere (d.h. einfachere, nachvollziehbarere und ressourcenschonendere) Modelle gar nicht erst in Betracht gezogen werden, selbst wenn sie für die Aufgabe völlig ausreichen würden. Ein Teilnehmer der Studie bringt diese Abwägung auf den Punkt: Wenn ein kleineres Modell bei 90 % statt 95 % Genauigkeit nur einen Bruchteil der Ressourcen benötigt, stellt sich die Frage, ob die 90 % für den konkreten Anwendungsfall nicht bereits ausreichen.
Praktisch lässt sich das im Guide so nutzen: Die Vergleichstabelle aus Schritt 4.2 (Modellgüte, Interpretierbarkeit, Ressourcenverbrauch nebeneinander) dient dann nicht nur der eigenen Dokumentation, sondern auch als Argumentationsgrundlage gegenüber Auftraggeber:innen oder Vorgesetzten.
Einen weiteren Ansatz für die Umsetzung von fachlichen, sozialen und ethischen Zielen zeigt sich bei Jegadeeswari und Rathipriya (2025). In ihrem Beispiel schlagen sie vor, den CO2-Ausstoß beim Trainieren bzw. Optimieren eines Modells als eigenständiges Optimierungsziel neben der Genauigkeit zu behandeln, statt Nachhaltigkeit erst nachträglich zu bewerten. Bemerkenswert ist ihr Befund, dass ein bestimmtes Tuning-Verfahren durchweg niedrige Emissionen bei gleichzeitig hoher Genauigkeit erzielte. Das ist ein Hinweis darauf, dass sich Nachhaltigkeit und Modellgüte mit der richtigen Herangehensweise nicht zwangsläufig ausschließen, sondern gemeinsam optimiert werden können.
Referenzen
7Workspace
Starte passende Self-Checks direkt im Denkfabrik Workspace.
Self-Check 13